「文章を書かないAI」が出ました──返事は○×と点数だけ。だから100倍安い
9月15日、アメリカで、ちょっと変わったAIが発表されました。
名前は Jev(ジェヴ)。作ったのは、ChatGPTの土台になった技術を作った研究者の一人です。約2年、表に出ずに作っていたそうです。
何が変わっているかというと——このAIは、文章を書きません。
返事は、3種類だけ
ChatGPTに「お礼のメールを書いて」と頼むと、文章が返ってきます。Jevに同じことを頼んでも、何も返ってきません。
Jevが返せるのは、この3つだけです。
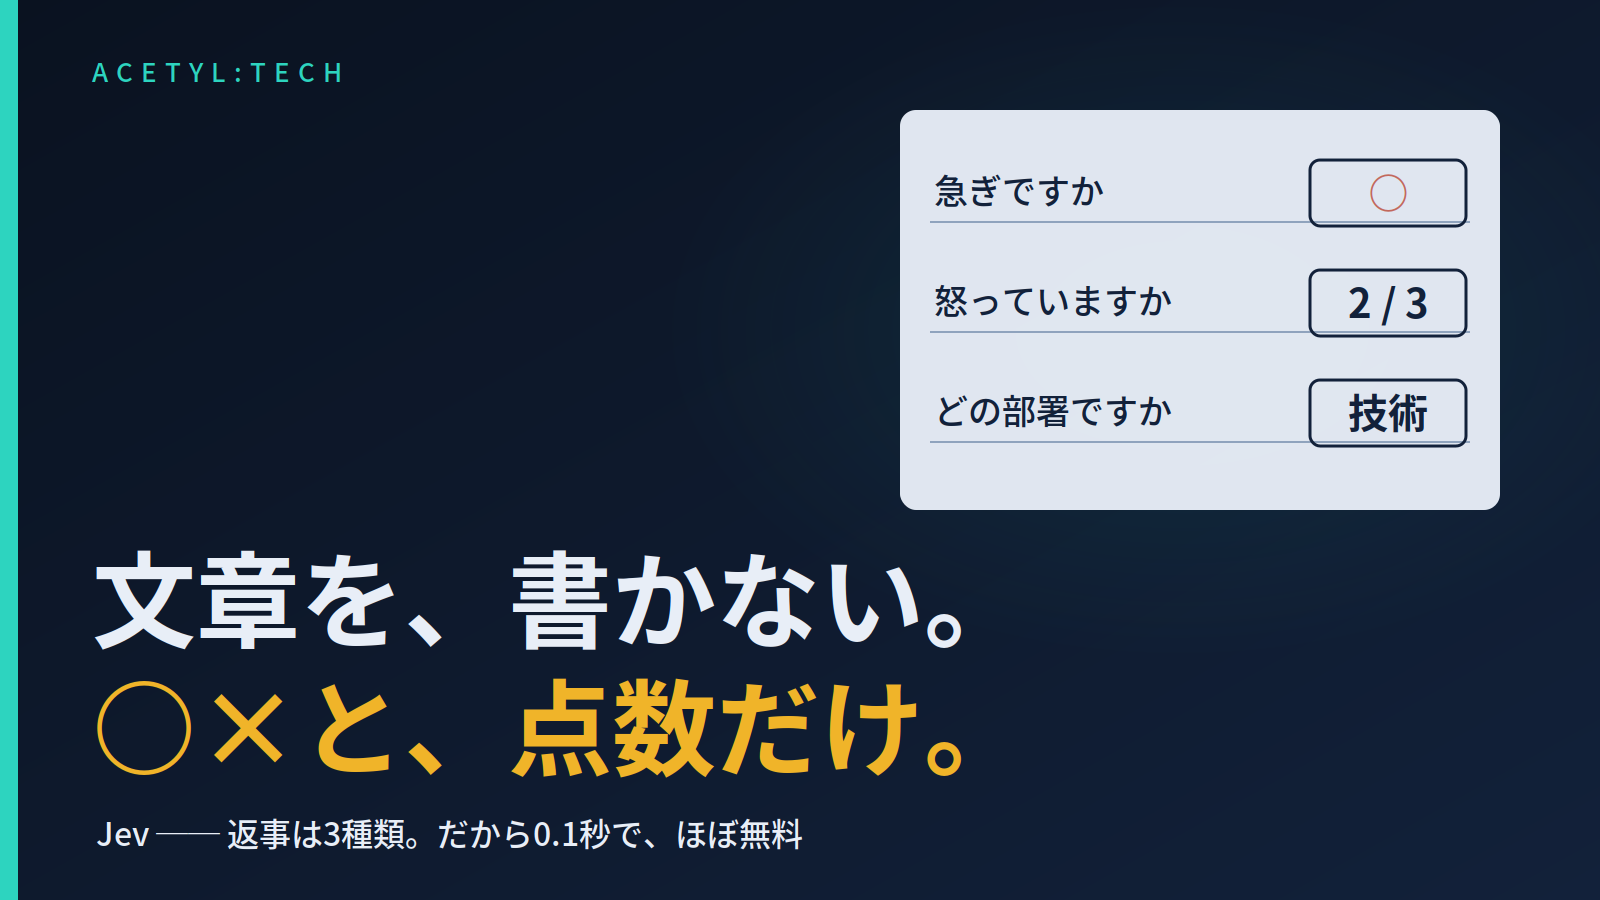
- ○か×か 例:「このメールは急ぎですか」→ はい、の確率 97%
- 点数 例:「このお客さんは、どれくらい怒っていますか」→ 3段階で「2」
- どれか一つ 例:「この問い合わせは、請求・技術・営業のどれですか」→「技術」
つまり、作文をする新人ではなく、答案用紙に○×と点数を付ける採点係です。
「それだけ?」と思われたかもしれません。それだけです。ただ、その「それだけ」に絞ったことで、速さと値段が桁違いになりました。
なぜ、文章を書かないだけで安くなるのか
ChatGPTのようなAIは、一文字ずつ、順番に文章を作っています。「次の一文字は何か」を予測して、書いて、また次を予測する。この繰り返しです。
だから、3つのことが起きます。
- 長い返事ほど、時間がかかる。 一文字ずつなので当然です
- 長い返事ほど、料金がかかる。 書いた文字の分だけ課金されます
- 途中で形が崩れる。 「表にして返して」と頼んでも、たまに表になっていない。順番に書いている途中で、道を逸れるからです
Jevは、この「一文字ずつ書く」をやりません。答えの型を先に決めておいて、○×と点数を一度に付ける。 答案用紙の記入欄が最初から印刷されていて、採点係はそこに印を入れるだけ、という状態です。
だから、返事の長さに関係なく速い。書いた文字に課金されない。そして、記入欄の外には何も書けないので、形が崩れない。
しかも、質問を25個まとめて聞いても、返ってくる時間はほぼ同じです。採点係が答案用紙の欄を、上から順ではなく一度に埋めるからです。「急ぎか」「怒っているか」「どの部署か」「予算はいくらか」を、一回で聞けます。
TypeSafe社はこれを「システム1」と呼んでいます。心理学で「速い直感」を指す言葉です。じっくり考えて文章を書くのではなく、見た瞬間に○か×かを決める。そういうAIです。
数字で言うと
速さ。 返事が返ってくるまで、公式の発表で0.07秒から0.5秒。試した人の計測では0.3秒から1.5秒くらいで、ばらつきはあります。それでも、発表時のデモでは同じ質問に Jev が 0.1秒、大手の文章AIが 8.6秒 でした。
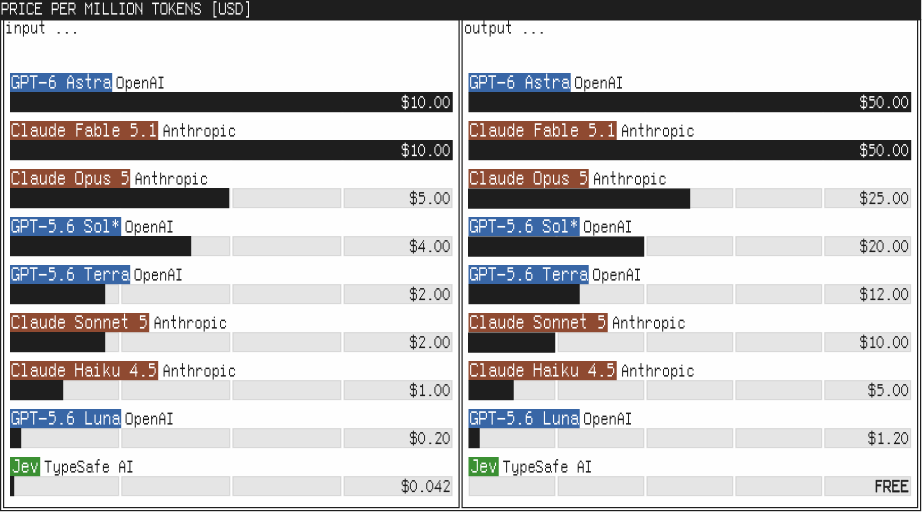
安さ。 料金は「読ませた文字の量」にだけかかり、返事は無料です。試した人の計算では、質問3つで約0.000018ドル。1ドル150円で計算すると、約0.003円。はがき1枚の切手代(85円)で、3万回以上聞けます。
TypeSafe社の公式サイトには、文章を書く大手AIと比べて「読ませる料金が238分の1」と書いてあります。
https://framerusercontent.com/images/TP6hevKFcoidcIYjUvx3uEMVPU0.svg?width=922&height=512
3日で、こんなものが作られました
Jevとgpt-live-1を使ってECのリアルタイム接客デモ作りました。会話途中でもユーザーの発話に合わせておすすめ商品を即座に出してくれるのはかなり体験良さそう。あと今回のデモではちゃんと簡単にしか作ってないけど、対話内容に応じてアバターの表情を変化させるって芸当もJevならでは。 — Rinte(@rinte0321)2026年9月18日 https://x.com/rinte0321/status/2100736454850908344?s=20
発表から3日で、こういう試作を作った人がいます。左でお客さんと会話しながら、右でその会話から「贈り物か自分用か」「予算はいくらか」「浅煎りか深煎りか」を○×と点数で判定し、合う商品を並べる。会話の途中で、判定が変わる。 文章を書くAIでは、返事を待っている間に会話が進んでしまって、こうはなりません。
ただし、これは試作です。お店で動いているものではありません。
今回、覚えて帰っていただきたいこと
一つだけです。
AIには、「文章を書くAI」と「判断だけするAI」の2種類ができた。
御社の仕事の中で、「文章」が要る場面と、「○×・点数・振り分け」で足りる場面は、たぶん半々くらいあります。後者の値段が、9月15日に、ほぼゼロになりました。
ただし、Jevはまだ「早期アクセス」で、申し込んで順番を待つ段階です。今日買えるものではありません。この連載は「今すぐ入れましょう」ではなく、来年の見積もりの前提が変わる、という話です。
次回への導入:「間違えない」は、本当か
ここまで読んで、たぶん一つ引っかかっていると思います。
Jevは「ハルシネーションしない」——AIが勝手なことを言わない——と宣伝されています。答案用紙の枠の外には何も書けないのだから、それは本当です。
でも、○を付ける場所を間違えることは、ないのでしょうか。
実は、発表から3日で外部の人が自分の手で試した結果が出ていて、昔ながらの「もし〜なら」の手書きルールに負けた例があります。日本語は、まだ検証されていません。「間違えない」という言葉が何を約束していて、何を約束していないか。そこを分けないと、任せてはいけない仕事まで任せてしまいます。
次回は、Jevの正しい疑い方と、御社の業務のどこに入って、どこに入らないかを書きます。
→ 第2回:「間違えないAI」は、何を間違えないのか──Jevの正しい疑い方と、御社で入る場所
出典・参考
- Introducing System One Models & Jev(TypeSafe AI 公式ブログ、2026年9月15日)
- TypeSafe AI 公式サイト——料金表示
- TypeSafe AI、AIモデル「Jev」の早期提供を開始(gihyo.jp、2026年9月)
- TypeSafe AI debuts model for machines that plays Doom(The Register、2026年9月16日)——0.114秒 vs 8.566秒のデモ
- What Is Jev? A Guide to TypeSafe AI's System One Model(LangChain、2026年9月17日)——質問を足しても時間がほぼ変わらない件
- awesome-typesafe-jev(GitHub)——質問3つで424トークン≈0.000018ドル、25問まで約0.25秒の実測
Read next
他の記事
「間違えないAI」は、何を間違えないのか──Jevの正しい疑い方と、御社で入る場所
文章を書かないAI「Jev」は「ハルシネーションしない」と宣伝されています。本当です。ただしそれは「用意した選択肢の外は出ない」という意味で、「選び方が正しい」という意味ではありません。第三者の試験では、単純なキーワードのルールに負け(97.2%対91.7%)、自信の数字が当てにならない例も出ています。日本語はまだ検証されていません。だから使い方は「人の代わり」ではなく「人の前の下読み」。問い合わせの振り分け・請求書の仕分け・口コミの採点には入り、返信文・報告書・写真には入らない。御社の業務のどこに入るかを、専門用語なしで書きます。連載第2回。
読む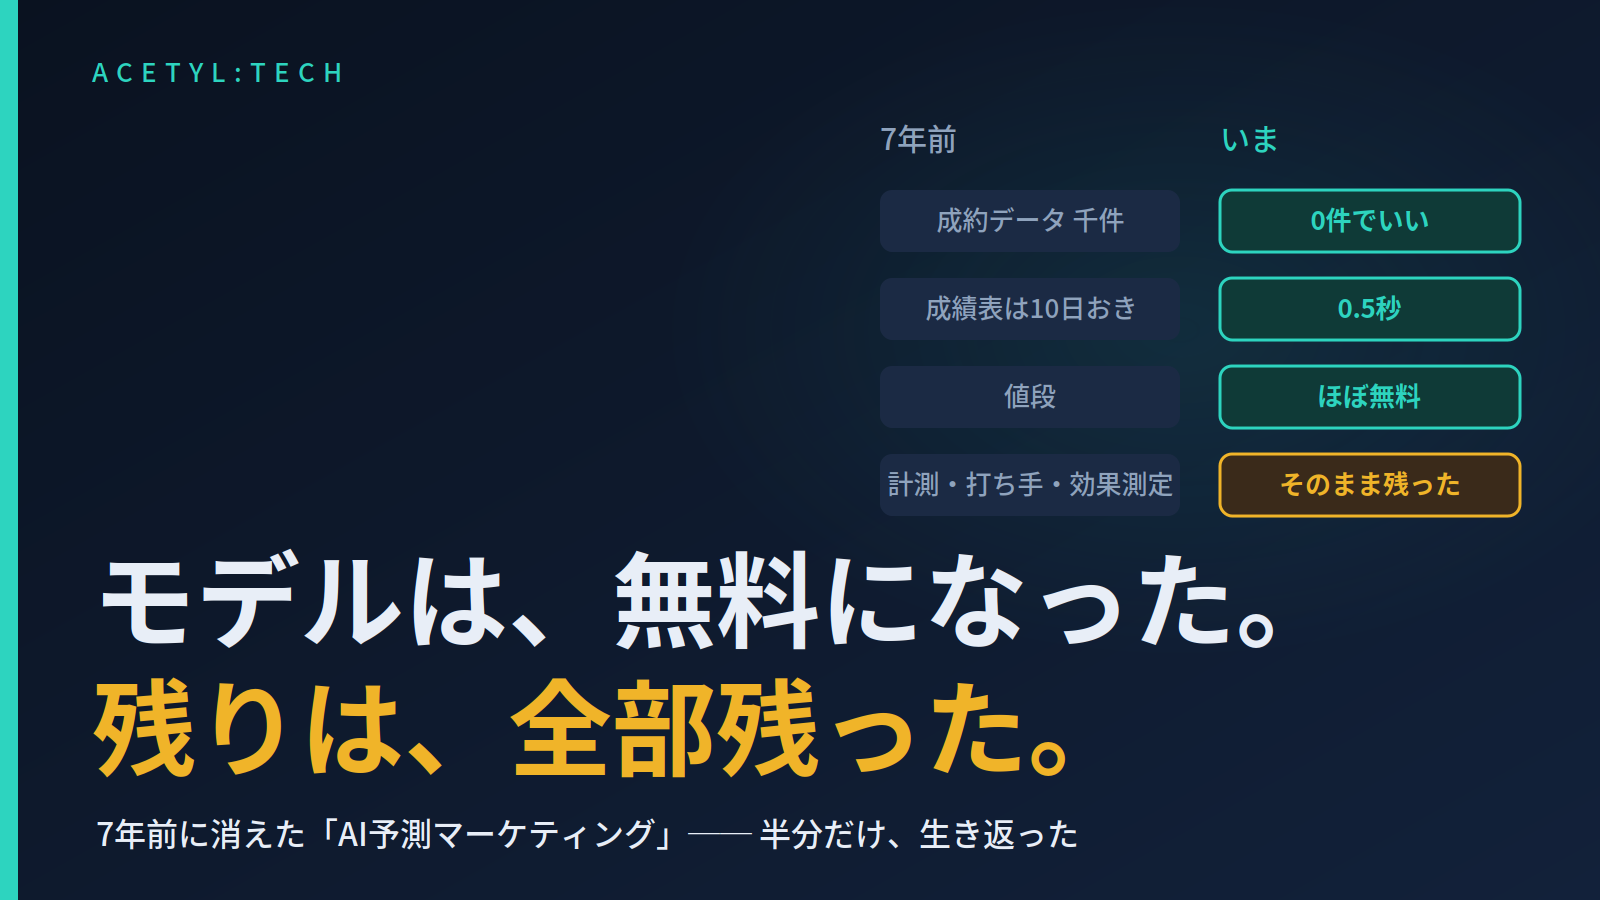
7年前に消えた「AI予測マーケティング」が、半分だけ生き返った──Jevで御社が今やること
2018年ごろ、「お客の行動からAIが買いそうな人を当てる」予測マーケティングが流行り、消えました。中小企業に届かなかった理由は3つ。自社の成約データが半年で千件要ったこと、成績表が10日に1回だったこと、値段。Gartnerは2019年に「2025年までに8割が撤退する」と予測しました。文章を書かないAI「Jev」は、この3つを消しました。学習データが要らず、返事は0.5秒、質問3つで0.003円。ただし残った壁が4つあります。計測を自分で仕込むこと、迷っている客に何を出すか、効いたかを測ること、判断の質。7年前はモデルが買えなかった。いまはモデルはほぼ無料で、それ以外が全部残っている。御社が今やること3つまで。連載第3回。
読む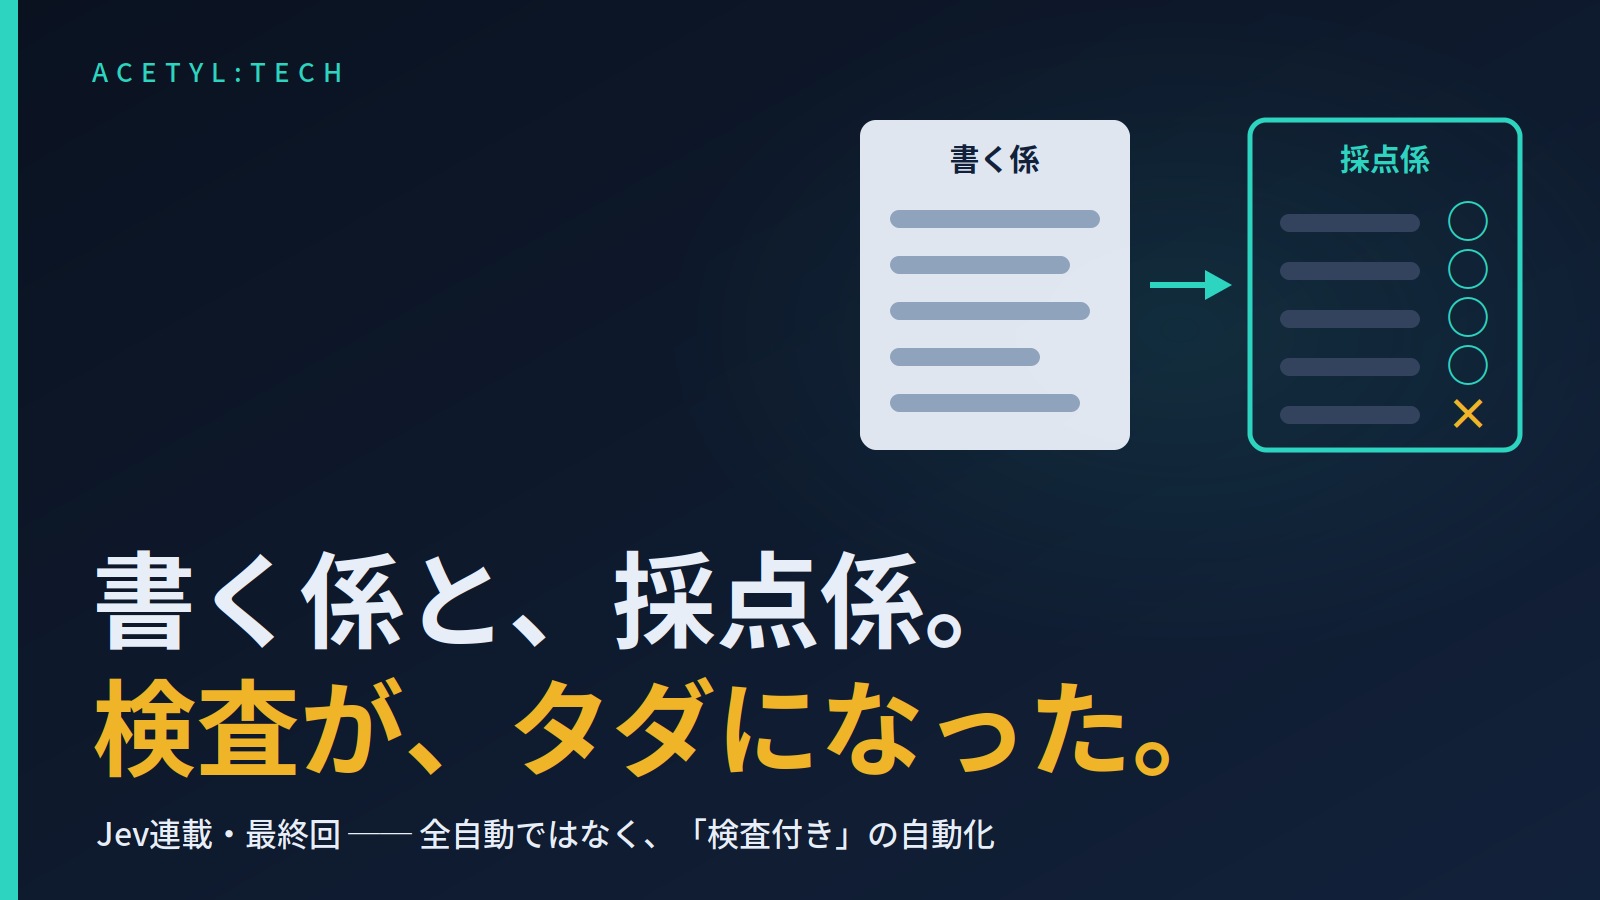
「書くAI」と「採点するAI」をつなぐと、何が起きるか──全自動ではなく、「検査付き」がタダになる
文章を書かないAI「Jev」は、ChatGPTのような文章AIの代わりではなく、横に置く採点係です。文章AIが書いた返信を送る前に、「質問に答えているか」「値引きを約束していないか」「社外秘に触れていないか」を5問、0.5秒、ほぼゼロ円で検査する。今までは検査は「人がやるか、やらないか」でした。検査がほぼ無料になったので、「検査付きの自動化」が「検査無し」と同じ値段で組めます。ただし採点係は「人を呼ぶ側」に置くこと。「人を外す側」に置いた全自動は、判断を10段つなぐと机上の計算で4割しか当たりません。Jev連載の最終回。連載で一番言いたかった話です。
読む