なぜ「会社のAI」でなければいけないのか──仕組みから見た、マスキングが要る5つの理由
支援先で作った AI 利用ルールの 1 つ目に、こう書きました。
顧客情報は、会社の AI にだけ入れる。
誰からも、理由を聞かれていません。 ルールとして受け入れられて、それで終わりました。
でも、そこが引っかかっています。理由が分からないまま守られているルールは、そのうち守られなくなるからです。
忙しい日に、目の前に締切があって、手元に使い慣れたアカウントがある。そのとき——なぜ駄目なのかを知らない人は、たぶん使います。悪意ではなく、単に「大丈夫だと思ったから」です。
AI がテスト環境を越えた件で「言葉で書いた制約は、制約にならない」と書きました。同じことがルールにも言えます。配っただけでは足りない。
だから書いておくことにしました。なぜ、会社の AI でなければいけないのか。
先に:「学習に使われないから安全」は、半分しか正しくない
いちばんよく聞く理解が、これです。
法人プランなら、入力した情報は学習に使われない。だから安全。
前半は正しいです。多くの法人向けプランでは、入力した内容を学習に利用しないことが契約上定められています。
でも、そこから「安全」に飛ぶのが早すぎる。
学習に使われないことと、保存されないことは、別の話です。
学習に利用されない場合でも、入力したデータは提供元のサーバーに保存されます。保存期間や、人による確認の有無は各社で異なります。たとえば Anthropic は、商用プランであっても、利用者が応答に評価(👍👎)を送った場合、関連する会話が最大 5 年間保存され、モデルの改善に使われる可能性があると説明しています。
学習の可否と、保存期間は、別々に確認する必要があります。
そして保存されている以上、そこは自社の管理外です。
仕組みから見た、5 つの理由
「なぜマスキングが要るのか」を、AI 側の動きから説明します。
① 渡したものは、全部読まれる
人に資料を渡すとき、私たちは無意識に前提を持っています。「関係ないところは読み飛ばすだろう」「ここは見なかったことにしてくれるだろう」。
AI には、それがありません。
プロンプトに含めた文章は、全部が処理の材料になります。「参考までに貼っておいた部分」も、「消し忘れた行」も、区別されません。
コピペしたエクセルの、使わない列に顧客名が入っていた——これで十分に渡したことになります。
② 出力に、そのまま出る
これが実務でいちばん起きます。
顧客とのやり取りを貼って「要約して」と頼めば、要約の中に顧客名が出てきます。当然です。入力にあったものを使って書いているので。
そして——その要約をコピーして、別の場所に貼る。社内チャット、議事録、報告書。
複製が増えます。 最初に貼った 1 回が、5 か所になる。
③ AI は「これは個人情報だ」と判断して避けてくれない
ここは誤解されやすいところです。
AI は、渡された情報について「これは扱いに注意すべきものだ」と自動で判断して、伏せてくれるわけではありません。指示されなければ、普通に使います。
そして「個人情報は出さないで」と書いても、それは前の記事で書いた通り、言葉での制約です。おおむね従いますが、保証ではありません。
判断の責任は、渡す側にあります。
④ 学習と保存は、別の論点
上で書いた通りです。改めて整理すると、確認すべきことは 3 つあります。
| 確認すること | 何が違うか |
|---|---|
| 学習に使われるか | モデルの改善に使われるかどうか |
| どれくらい保存されるか | 使われなくても、サーバーには残る |
| 人が見ることがあるか | 不正利用の監視などで、人の目に触れる場合がある |
「学習に使われません」だけを確認して終わりにしない、ということです。
⑤ 断片は蓄積し、組み合わさると特定される
そして、いちばん見落とされるのがこれです。
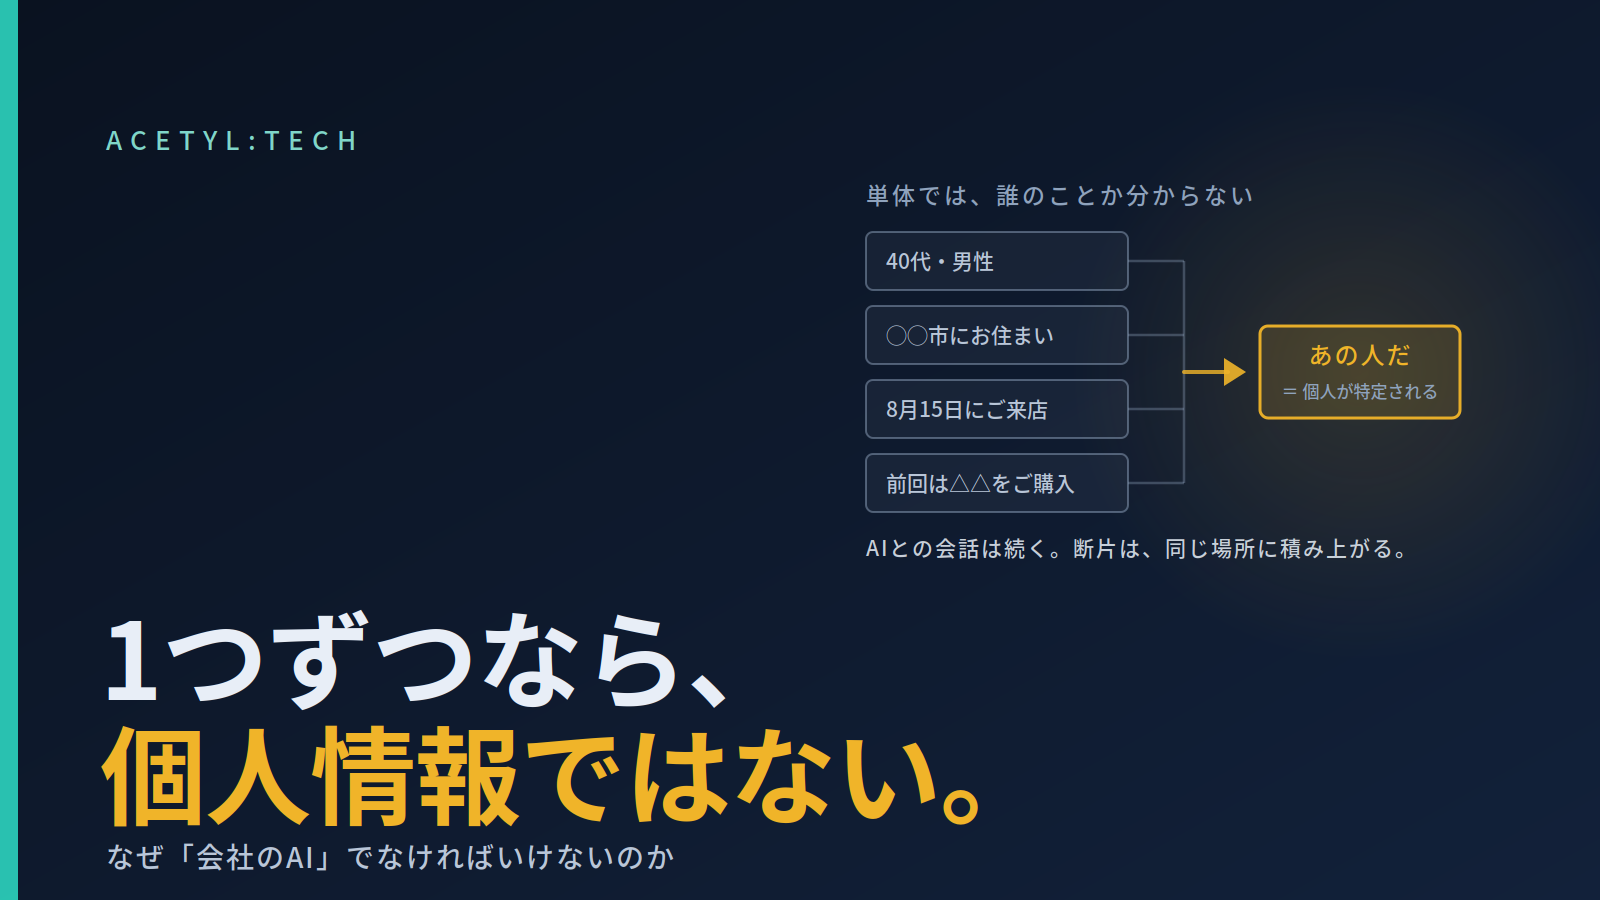
1 つずつは、個人情報ではない情報があります。
- 「40 代の男性」
- 「◯◯市にお住まいの方」
- 「8 月 15 日にご来店」
- 「前回は△△をご購入」
単体なら、誰のことか分かりません。 でも AI との会話は続きます。今日の質問、明日の質問、来週の質問。同じスレッドに、断片が積み上がっていく。
そして揃った時点で、特定できる状態になります。
実務で難しいのは、まさにここです。「個人名は入れない」までは、たいてい決まっています。でも——
部署名は? 会社名は? 日付は? 金額は? そして、単体では問題ないのに、組み合わせると特定できてしまう場合は?
ここに線を引くのが、いちばん頭を使う部分です。
これには、名前がついています
「単体では個人を特定しないが、組み合わせると絞り込める属性」——これは**準識別子(quasi-identifier)**と呼ばれます。データの匿名化を扱う分野では、古くから知られている概念です。
生年月日、性別、郵便番号、職業、来店日。どれも単体では誰か分かりません。 でも重ねると、範囲が急速に狭まります。
州知事の医療記録が特定された話
この分野で最も有名な事例を紹介します。2002 年、研究者ラタニヤ・スウィーニーによるものです。
当時、マサチューセッツ州は職員の医療データを公開していました。氏名は削除済みで、匿名化されているという前提です。
スウィーニーは、そこに別のデータを突き合わせました。公開・販売されていた投票者名簿です。
結果はこうでした。
| 手順 | 絞り込まれた人数 |
|---|---|
| 州知事と同じ生年月日のレコードを探す | 6 人 |
| そのうち男性に絞る | 3 人 |
| 郵便番号を加える | 1 人 |
州知事の医療記録が、特定されました。
使ったのは、生年月日・性別・郵便番号の 3 つだけ。どれも、それ単体なら「個人情報ではない」と言われそうな項目です。
なお、2019 年に Nature Communications に掲載された研究でも、匿名化されたデータセットから個人を再特定することの容易さがあらためて示されています。この問題は、古くて新しいということです。
そして AI との会話は、突き合わせが自動で起きる
スウィーニーの事例では、人間が 2 つのデータを突き合わせました。
AI との会話では、それが同じスレッドの中で自然に起きます。今日の質問と、先週の質問と、昨日貼った資料が、すべて同じ文脈に載っている。
わざわざ突き合わせなくても、最初から並んでいるわけです。
そして、一度渡したら取り消せない
ファイルなら、削除できます。誤送信したメールも、相手に頼めば消してもらえる可能性があります。
AI に渡した情報は、どうでしょうか。
- 提供元のサーバーに、どれくらい残っているか——契約で決まっていて、自社では動かせない
- 出力をコピペした先に、いくつ複製ができたか——追えない
- 別のスレッドで、同じ情報を再入力していないか——分からない
つまり、渡した後にできることが、ほとんどありません。
だから渡す前に判断するしかない。マスキングが「入り口」の作業である理由が、ここにあります。
法律は、何と言っているか
技術の話だけでなく、制度の話も押さえておきます。
個人情報保護委員会は 2023 年 6 月 2 日、生成 AI サービスの利用について注意喚起を出しています。 要点はこうです。
個人情報取扱事業者が、あらかじめ本人の同意を得ることなく生成 AI サービスに個人データを含むプロンプトを入力し、当該個人データが応答結果の出力以外の目的で取り扱われる場合、個人情報保護法の規定に違反することとなる可能性がある。 そのため、当該サービスを提供する事業者が、当該個人データを機械学習に利用しないこと等を十分に確認すること。
要するに——学習に使われる状態で個人データを入れると、事業者への「第三者提供」(個人情報保護法 27 条)に当たりうる、という整理です。第三者提供には、原則として本人の同意が必要になります。
逆に言えば、学習に利用されない契約であれば「委託」として整理できる可能性が高まる。ここが「会社の AI にだけ」の法的な根拠です。
そして、規制は強まる方向です。2026 年 4 月には個人情報保護法の改正案が閣議決定され、違法な取扱いで利益を得た場合の課徴金制度が盛り込まれました。
プランによって、扱いが 3 段階で違う
同じ「ChatGPT」「Claude」でも、契約によって扱いが変わります。ここは正確に押さえたほうがいい部分です。
| 学習利用 | 管理 | |
|---|---|---|
| 無料版 | 利用される可能性がある | 設定変更は本人任せ |
| 有料の個人プラン | 設定でオフにできる | 本人任せのまま |
| 法人プラン | 契約上、禁止されている | 管理者が一括で制御できる |
2 行目が肝です。有料の個人プランで「学習オフ」にしていても、それは本人の設定次第。会社としては、設定されているかを確認できません。
だから「会社の AI にだけ」というルールになります。個人が正しく設定しているかを信じる運用ではなく、会社として一度決めれば全員に効く運用にするためです。
では、何を消して、何を残すのか
ここが実務の核心です。全部消せばいい、という話ではありません。
全部マスキングすると、AI の回答も役に立たなくなります。
「◯◯様から△△について問い合わせがありました」を「A 様から B について問い合わせがありました」にすれば安全ですが、それで「どう返信すべきか」と聞いても、当たり障りのない返事しか返ってきません。
必要なのは、業務の構造を残して、個人を特定する部分だけを外すことです。
3 種類に分けて考える
上で触れた匿名化の分野には、属性を 3 つに分けるという整理があります。これがそのまま実務に使えます。
| 種類 | 例 | 扱い |
|---|---|---|
| 直接識別子 | 氏名、電話番号、メールアドレス、顧客 ID | 消す |
| 準識別子 | 生年月日、性別、住所、職業、来店日 | 粗くする |
| 機密情報(守りたい中身) | 相談内容、症状、契約の状況 | 残す |
3 行目が重要です。守りたいのは 3 行目であって、消すべきは 1 行目と 2 行目。3 行目まで消してしまうと、AI に聞く意味がなくなります。
「消す」ではなく「粗くする」
2 行目の準識別子には、一般化という手法があります。値を消すのではなく、粗くする。
| 元 | 粗くする |
|---|---|
| 38 歳 | 30 代 |
| 8 月 15 日 | 先週 |
| 柳川市 | 県内 |
| 歯科医師 | 医療従事者 |
| 株式会社◯◯(従業員 12 名) | 小規模な取引先 |
情報を捨てているようで、判断に必要な部分は残っています。 「30 代の方から先週いただいた相談」で、たいていの用は足ります。
そして、これは最適化問題です
ただし、粗くしすぎると別の問題が起きます。
匿名化の研究では、この点がはっきり指摘されています。準識別子を思い切り一般化すれば、特定されるリスクは簡単に下げられる。年齢を全部「0 歳以上」にすればいい。でも——それではデータが粗すぎて、分析の役に立たない。
だからこう整理されています。
「特定されない」という制約のもとで、有用性をできるだけ高く保つ最適化問題。
マスキングも同じです。安全側に振り切れば安全ですが、AI が役に立たなくなる。逆に情報を残しすぎれば、特定される。
この 2 つの間のどこかに、その業務にとっての正解があります。 そして正解は業務ごとに違うので、一度決めて、社内で共有するしかない。
外すもの
- 氏名(フルネーム、姓のみでも地域によっては特定される)
- 生年月日・年齢(年代までなら残せる場合が多い)
- 住所・電話番号・メールアドレス
- 顧客 ID・会員番号・契約番号
- 勤務先や学校名(小さい組織ほど特定に近づく)
- 日付(「8 月 15 日」より「先週」のほうが安全)
残すもの
- 業務の構造——どういう手順で、何が起きたか
- 問い合わせの内容そのもの——何に困っているか
- やり取りの経緯——いつ何を伝えたか(時系列の相対関係)
- 判断に必要な条件——契約の種別、対応の履歴の有無など
「誰か」を消して、「何が起きているか」を残す。 これが基本形です。
組み合わせに注意する
そして⑤で書いた通り、単体では大丈夫でも、組み合わせると特定されることがあります。
判断に迷ったら、こう自問するのが実用的です。
この文章だけを見た第三者が、社内の人に「これ誰のこと?」と聞いたら、答えられてしまうか。
答えられてしまうなら、まだ削る余地があります。
現実的な運用
とはいえ、毎回これを判断するのは負担です。仕組みで減らせる部分があります。
1. 会社の AI を用意する——これが最初。受け皿がなければ、個人アカウントが使われます
2. 使う場面を決めておく——「顧客とのやり取りは、この形に整えてから渡す」という型を作る
3. 出力を、そのまま外に出さない——AI 利用ルールの 4 つ目で書いた通り、人が読んでから出す。入力側の対策では、出力の誤りは防げません
4. 迷ったら聞ける相手を決めておく——判断に迷う場面は必ず来ます。そのとき止まらないように
まとめ
- AI 利用ルールに「顧客情報は会社の AI にだけ」と書いたが、理由を説明していなかった。理由を知らないまま守られているルールは、忙しい日に破られる
- 「学習に使われないから安全」は半分しか正しくない。学習の可否と保存期間は別の論点。Anthropic は商用プランでも、評価を送った会話が最大 5 年保存されうると説明している
- 仕組みから見た理由は 5 つ。①渡したものは全部読まれる ②出力にそのまま出る ③ AI は判断して避けてくれない ④学習と保存は別 ⑤断片は蓄積し、組み合わさると特定される
- そして一度渡したら取り消せない。だから入り口で判断するしかない
- 制度面では、個人情報保護委員会が 2023 年に注意喚起。学習に使われる状態での入力は「第三者提供」に当たりうる。2026 年 4 月には課徴金制度を含む改正案が閣議決定
- プランは 3 段階。有料の個人プランは「本人任せ」のまま。だから会社として契約する意味がある
- 「単体では特定できないが、組み合わせると絞り込める属性」には名前がある。準識別子(quasi-identifier)
- 2002 年、氏名を削除したマサチューセッツ州の医療データから、州知事の記録が特定された。使われたのは生年月日・性別・郵便番号の 3 つだけ。同じ生年月日が 6 人 → 男性 3 人 → 郵便番号で 1 人
- そしてAI との会話では、その突き合わせが自動で起きる。断片が最初から同じ文脈に並んでいるから
- 属性は 3 つに分けて考える。直接識別子は消す/準識別子は粗くする/機密情報(守りたい中身)は残す
- 準識別子は「消す」より「粗くする」。38 歳→ 30 代、8 月 15 日→先週、柳川市→県内
- そして全部消せばいいわけではない。これは「特定されない制約のもとで、有用性をできるだけ高く保つ最適化問題」。「誰か」を消して、「何が起きているか」を残す
- 迷ったら——この文章だけを見た第三者が、「これ誰のこと?」と聞いて答えられてしまうか
ルールは、守られて初めて意味があります。そして守られるためには、なぜそうなのかが分かっている必要がある。
この記事は、そのための説明です。
Acetyl:Tech は、AI をどこまで業務に入れるかの線引きから支援しています。 「使いたいが、顧客情報の扱いが不安」という段階のご相談も承ります。詳しくは「AI 導入・社内研修の支援」のページをご覧ください。
出典・参考
- 個人情報保護委員会「生成 AI サービスの利用に関する注意喚起等について」(2023 年 6 月 2 日)
- 個人情報保護委員会「生成 AI サービスの利用に関する注意喚起(パンフレット)」(2023 年 8 月)
- AI 活用ブログ「生成 AI に個人情報を入力してよいのか|法令の要件とツール別の学習させない設定」 ── 学習と保存が別の論点である点、保存期間の実例
- インターネットプライバシー研究所「生成 AI の業務利用と個人情報保護 – 入力可否の判断基準と社内ルール整備」 ── プラン別の 3 段階
- 牛島総合法律事務所「生成 AI サービスに関する個人情報保護委員会からの注意喚起と実務への影響」 ── 第三者提供・委託の整理
- Uravation「【2026 年最新】生成 AI ×個情法 完全対応ガイド」 ── 2026 年改正案の内容
匿名化・準識別子について
- 東京大学ソーシャル ICT 研究センター「ソーシャル ICT サービスとプライバシー保護」 ── マサチューセッツ州知事の事例(L. Sweeney, 2002)
- Project SDC4Society「k-匿名化とは何か —— 個人を『群衆』に紛れさせるプライバシー保護技術」(2026 年 7 月) ── 直接識別子/準識別子/機密情報の 3 分類、一般化の手法、最適化問題としての整理
- IT 用語辞典 e-Words「k-匿名性」 ── 準識別子の定義
- MIT Technology Review「郵便番号と性別・生年月日だけで個人の特定は可能、新研究で判明」(2019 年) ── Nature Communications 掲載研究の紹介
- 経済産業省「匿名加工情報作成マニュアル」(2016 年 8 月) ── 属性の組み合わせによる特定リスク
※ 法的な判断が必要な場合は、弁護士等の専門家にご相談ください。本記事は公表資料の整理であり、法的助言ではありません。また各サービスの規約は変更されるため、契約前に必ず公式の最新情報をご確認ください。
Read next
他の記事
「AIのルールを作りたい」と言われて、4項目にしました──禁止事項を並べなかった理由
支援先の社長から「AIの使い方にルールを設けたい」と相談されました。きっかけは8月初旬のAIに関する報道です。指示は「まずは軽いテイストで」。出来上がったのは、禁止事項の羅列ではなく4項目だけのルールでした。なぜ承認制にしなかったのか、なぜ禁止ではなく行き先を書いたのか。実際に作った4項目と、その設計理由を公開します。
読む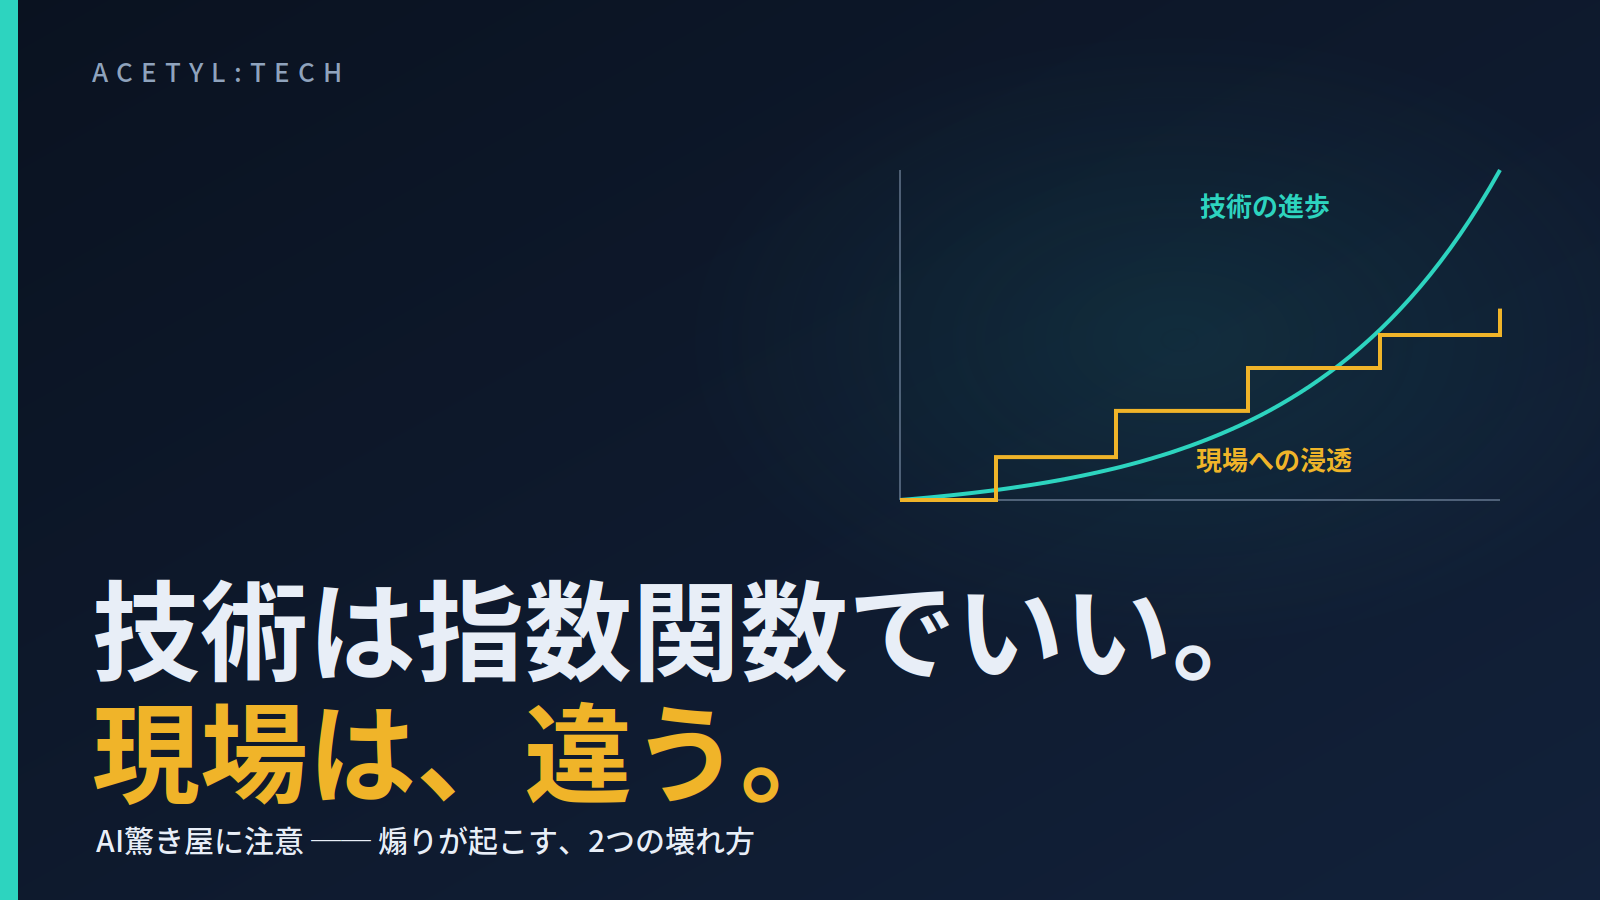
AI驚き屋に注意──技術は指数関数でいい。現場は違う
初回の打ち合わせで「うちはもう手遅れですか」と聞かれた回数は、片手では足りません。ただ、彼らは嘘をついていません。欠けているのは分母だけです。Ramp AI Index では最新最高のモデルが企業の買ったトークンの6%にとどまり、AI支出の中央値は従業員1人あたり月11.95ドル、上位1%との差は約620倍。GoogleですらGeminiのデモ動画を編集していました。そして2026年7月、Claudeの共有チャットとArtifactsが検索エンジンに出た件は、ほとんど流れてきませんでした。事故は「驚き」の在庫にならないからです。煽りが起こす「止まる」と「壊す」、そしてうちが書きかけて落とした4つの失敗まで。
読む
「社内用だから大丈夫」が、いちばん危ない──10月の漏えい連鎖で見えた、3つの入口
2026年9月の終わりから、大きな会社の個人情報漏えいの発表が相次ぎ、10月7日から9日の3日間で、国の機関などから注意喚起が8本出ました。ただ、各社の発表を読むと、どうやって入られたのかはほとんど書かれていません。手口が分かるのは、JPCERT/CCとマクニカが実際の対応から書いた資料だけです。それと各社の発表に残った数少ない言葉を突き合わせると、入口は3つに絞れます。アプリの中の鍵と画面の裏のAPI、「社内用」の管理画面やBIツール、そして委託先。どれも「表には出していないつもり」の場所で、中小企業にもそのままあります。業者や担当者に聞ける質問の形にしました。うちも委託先なので、自分たちの側の話も書きます。
読む