AI驚き屋に注意──技術は指数関数でいい。現場は違う
初回の打ち合わせで、この質問を何度も受けてきました。
「うちは、もう手遅れですか」
数は数えていません。ただ、覚えている範囲で片手では足りない。従業員が数人の会社の社長さんが、まだ何も導入していない段階で、すでに負けた顔をしている。
よく聞くと、原因はだいたい同じところにあります。SNSやYouTubeで流れてきた「AI活用」の情報を、しばらく浴びた。そして誤解したのではなく、脅かされている。
この記事は、その話です。
最初に立場を書いておきます。**当ブログは業務でClaudeを推奨しています。**そのうえで、この記事の後半ではClaudeに関する事故を扱います。都合よく書かないために、先に開示しておきます。
何を「過剰」と呼んでいるのか
まず、対象をはっきりさせます。批判の的が広すぎると、ただの悪口になるので。
この記事で扱うのは、YouTubeやXの、個人のペルソナを持ったAI情報発信専用アカウントが、エンドユーザー向けに出す情報です。それ以外は対象にしません。
| 対象にしない | 対象にする |
|---|---|
| 開発者が自分の実装について書いた技術記事 | 情報発信そのものが商品になっているアカウント |
| 企業の公式発表、研究者の論文紹介 | 実装も運用もせず、紹介だけで回している発信 |
| 新しい技術に素直に興奮している個人 | 検証手段を持たない読者に向けた、断定 |
境目は熱量ではありません。その人が何を売っているかです。
情報そのものが商品になっている場合、驚きは在庫です。切らすわけにいかない。毎日「今日いちばんヤバいやつ」を仕入れ続けなければ、アカウントが止まる。悪意の話ではなく、構造の話です。
言葉の整理
「プロ驚き屋」という呼び名は、2023年3月16日にnoteで公開された記事が語源とされています。ITmedia の記事(2024年9月、マスクド・アナライズ氏)では、こう定義されています。
最先端テクノロジーに対して、SNSなどで誇張表現を使ってその存在をアピールする人たち
典型的な型もほぼ共通しています。
- 「やばすぎる」「神」「最強」といった語を多用する
- 「医者/弁護士/プログラマーはもう必要ない」といった極端な未来予想
- 体言止めの箇条書きで、新しいツールや論文を並べる
- 都合の良い成功例だけを根拠にする
念のため書いておくと、新しい技術に興奮するのは正常なことです。最初に騒ぐ人がいなければ、普及はもっと遅れます。問題は熱量ではありません。
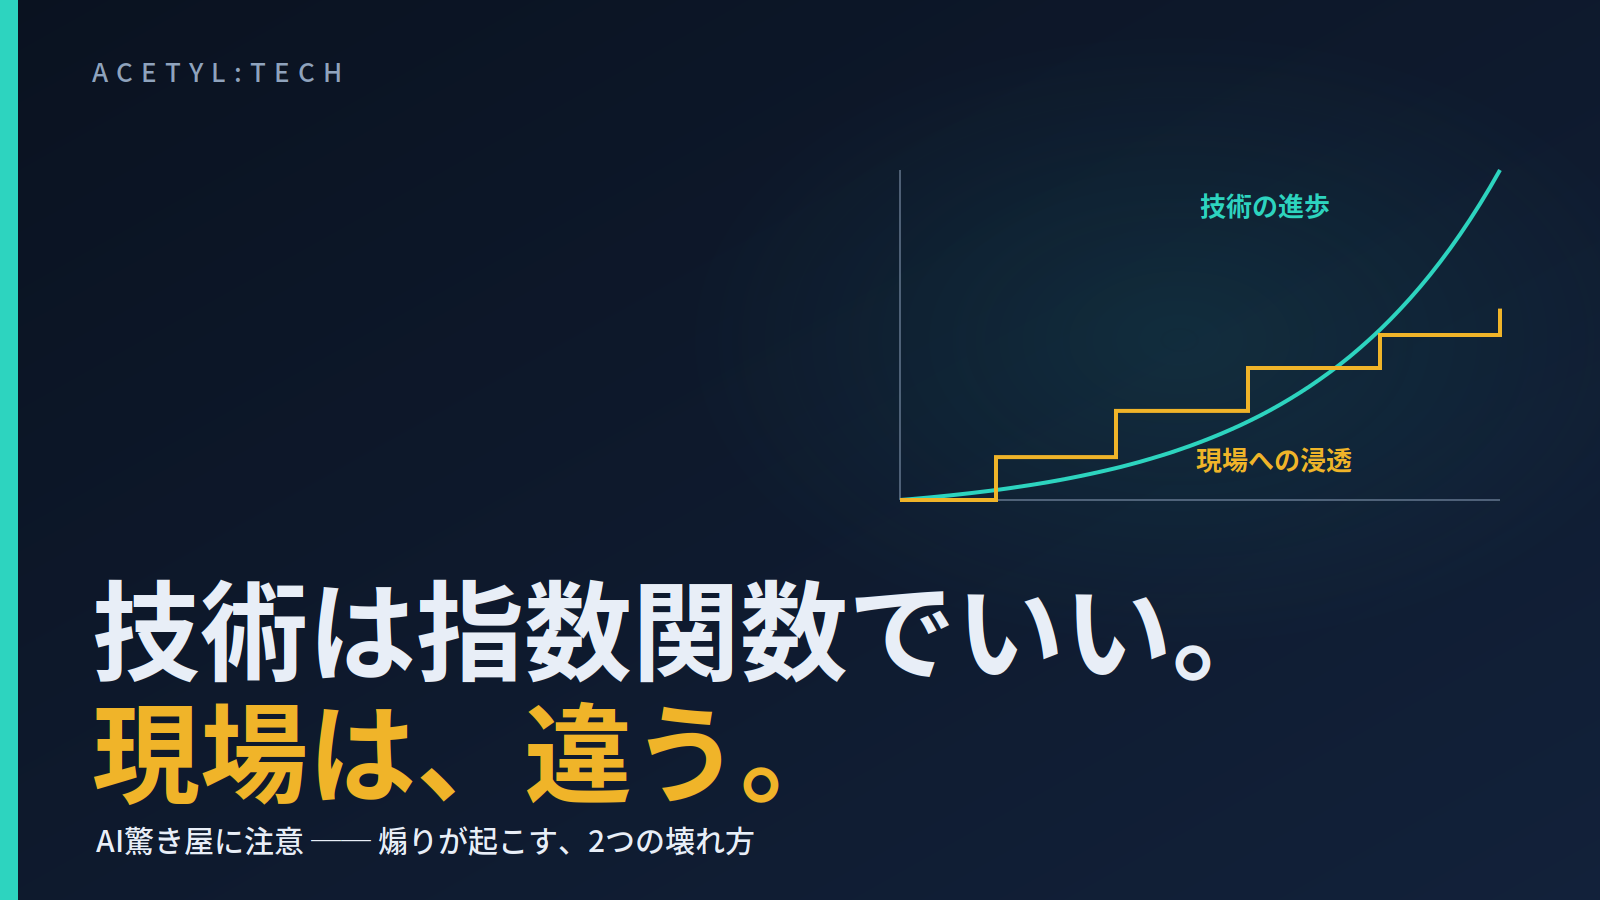
技術は指数関数でいい。現場は、違う
ここがこの記事の背骨です。
AIの技術的な進歩が指数関数的である、という主張は**否定しません。**実際そう見えますし、そこを疑う話ではない。
問題は、そこから現場への浸透の速度を、同じ曲線で語ってしまうことです。
この2本は、別の線です。
- 「モデルが2年で10倍賢くなった」は、事実
- 「だから御社も2年で10倍」は、嘘
現場への浸透は、階段でいい。というより階段であるべきです。1段上がったら、そこで固める。誰が使うのか、止まったらどうするのか、元のやり方に戻せるのか。それが決まってから次の段に足をかける。
技術の曲線に合わせて現場を引っ張り上げようとすると、途中の段を飛ばすことになります。飛ばした段は、あとで必ず取りに戻ることになる。
驚き屋の害は、嘘をつくことではありません。この2本を1本に見せることです。
では、1段とは何か
「階段でいい」と言うだけでは、何も言っていないのと同じなので、うちが1段と数えている中身を書きます。これまで別々の記事に書いてきたことを、1段の条件として並べ直したものです。
- 誰が使うかが決まっている。「みんなで使う」は、決まっていないのと同じです。名前が出てこないなら、その段はまだ乗っていません
- **止まったときに戻せる。**元のやり方を消していない、ということです。AIの応答が変わっても、業務は止まらない
- **出てきたものの置き場が決まっている。**生成された表やメモを、どこに、どの名前で置くか。ここを決めないと、次の節で書く「壊す」が起きます
- 1か月、実際に回っている。
4つ目がいちばん飛ばされます。1〜3が揃った時点で、もう次に行きたくなる。動いているので。
ただ、1か月回してみて初めて出てくる問題があります。月末にしか発生しない作業、担当者が休んだ日、例外的な取引先。ここで転ぶと、1段目に戻るのではなく、転んだまま2段目に足をかけている状態になります。
技術の側は、待ってくれます。急がなくても、勝手に伸びていくので。
嘘はついていない。分母がないだけ
では、彼らは何を間違えているのか。
多くの場合、**何も間違えていません。**紹介されるツールは実在します。デモは本当に動きます。ニュースは本物です。
欠けているのは、分母だけです。
米国の法人カード会社 Ramp が公開している AI Index の2026年8月版に、こんな数字があります。
| 指標 | 数値 |
|---|---|
| Anthropic を利用している企業 | 43.5% |
| OpenAI | 39.7% |
| xAI | 4.0% |
| Fable 5 が占める、企業がAnthropicから購入したトークンの割合 | 6%(支出ベースで11.4%) |
| GPT-5.6 Sol | トークンで25%、支出で23% |
Fable 5 は最上位のモデルです。実在します。本当に速いし、本当に賢い。SNSでもさんざん話題になりました。
それでも、企業が実際に買ったトークンの6%です。
そしてもうひとつ、こちらのほうが効きます。
| AI支出(従業員1人あたり・月額) | 金額 |
|---|---|
| 上位1%の企業 | $7,400 |
| 上位10%の企業 | $650 |
| 中央値の企業 | $11.95 |
上位1%と中央値の差は、約620倍です。図は対数ではなく同じ縮尺で描いていて、中央値の棒は線1本ぶんの幅しかありません。
SNSに流れてくる「AI活用」の話は、ほぼ全部が上の棒の話です。それを見て「うちは遅れている」と感じるのは、マラソン中継で先頭集団だけを見て、自分が最下位だと思うのに似ています。実際には、真ん中の人はまだ準備運動をしている。
なお、この「話題になっている量」と「実際に使われている量」のズレについては、「ChatGPTの方が分かりやすくない?」と言われて、まず聞き返したことでも触れました。あのとき仮説として書いたことが、今回はデータで裏づけられた形です。
Google ですら、デモは編集する
「でも動画で動いてるのを見た」という反応があります。
2023年12月、Google が Gemini の "Hands-on" デモ動画を公開しました。手をかざすとリアルタイムで反応する、印象的な映像です。
そして Google 自身が、動画の説明欄でこう書いています。
We created the demo by capturing footage…Then we prompted Gemini using still image frames from the footage, and prompting via text. (映像を撮影してデモを作りました。そのうえで、映像から取り出した静止画のフレームと、テキストによる指示で Gemini にプロンプトしました)
TechCrunch が指摘した相違点が具体的です。
| 動画で見えたもの | 実際に必要だったもの | |
|---|---|---|
| じゃんけん | 手の動きに即座に「じゃんけんしてるね!」 | 3つのジェスチャーを一度に見せ、「Hint: It's a game」というテキストのヒントを添える |
| 惑星の順序 | 自然な質問に即答 | 「太陽からの距離を考え、理由を説明せよ」という詳細な指示 |
大事なのは、これは捏造ではなく編集だということです。素材は本物で、Gemini は実際にその答えを出しています。並べ替えて、間を詰めて、指示を画面の外に出しただけ。
そして、動画とはそもそもそういうものです。**「こう見せたい」順に並べ替えられる。**世界最大級の企業が公式に出す動画ですらこうなるなら、個人が一人で作って一人で編集した動画は、なおさらです。
煽りが起こす、2つの壊れ方
ここまでが「何が起きているか」です。ここからが「何が壊れるか」。
ここで「情報商材に騙される人が増えている」と書きたくなります。書けば話は締まります。
**ただ、データは逆でした。**国民生活センターに寄せられた情報商材の相談件数は、3年連続で減っています。
| 年度 | 件数 |
|---|---|
| 2023年度 | 6,256 |
| 2024年度 | 4,163 |
| 2025年度 | 2,623 |
だから、詐欺の線では書きません。実害は、そこではないということです。
害は2方向に出ます。止まるか、壊すか。
止まる
2026年版の中小企業白書に、こんな数字があります。
| 事実 | 数値 |
|---|---|
| AI活用に取り組んでいない企業 | 73.6% |
| 取り組まない理由 1位「活用する業務がイメージできていない」 | 63.4% |
| 同 2位「推進する人材が不足している」 | 40.0% |
1位が「イメージできていない」であることに注目してください。「効果がない」でも「費用が高い」でもありません。自分の会社の、どの仕事に当てはめればいいのか分からない。
煽りを浴びると、この状態が悪化します。期待値だけが先に上がるからです。
「AIで営業が10倍」を見たあとで、目の前にある「請求書の宛名を毎月手で直している」という仕事を見ると、あまりに地味に見えて、着手する気が失せる。本当はそこが正解なのに。
このあたりはほとんどの会社に、いま「AI導入」は必要ありませんに書いたことと同じです。
冒頭の「うちはもう手遅れですか」に対して、私はだいたい同じことを聞き返しています。
「いま、いちばん時間を取られている作業は何ですか」
ここで出てくるのは、ほぼ例外なく地味な作業です。同じ数字を2か所に打ち込んでいる。毎月同じ書式の書類を作り直している。電話で聞いた内容を、あとでノートに書き写している。
**そして、そのどれもが手遅れではありません。**むしろ何も始めていないぶん、余計な置き場が増えていないので、着手しやすい状態にあります。
遅れているのは会社ではなく、期待値のほうが先に行ってしまっているだけです。
壊す(こちらのほうが深い)
止まるのは、まだ被害が可逆です。深いのはこちらです。
検証しないまま入れると、既存の台帳の"横"に、もう一つデータの置き場ができます。
これが厄介なのは、表面に出ないことです。動いているように見える。むしろ最初のうちは便利になる。壊れているのは、もっと深いところ——「どれが正か」が決まらなくなったという一点です。
そしてAIは、この構造を作るのが特にうまい。
- チャットの履歴に、決定の経緯が残る
- 生成させたスプレッドシートに、集計結果が残る
- 要約させたメモに、会議の結論が残る
全部が「正」の候補になります。3か月後、数字が合わないときに、どれを見ればいいのか誰も言えない。
これは新しい問題ではありません。「エクセルの転記を自動化したい」の前にで書いたとおり、**同じ情報を複数の場所に入力する「二重入力」を経験している人は56%**います(株式会社オロ、2026年5月/働く人対象)。原因は個人の怠慢ではなく、部門ごとに部分最適化された構造です。
AIは、その構造を一段速く作ります。
経産省が言い始めた「AI-Ready化」で、実家の医院の請求と勤務時間管理のデータ構造を整理し直した話を書きました。あのときやったことは、要するに二重管理をなくして、どれが正かを決めただけです。派手さはありませんが、あれをやらずにAIを載せると、載せたぶんだけ置き場が増えます。
驚き屋が扱わないもの ── 事故は「在庫」にならない
さて、ここからが本題です。
当ブログはClaudeを推奨しています。だからこそ、この節を書きます。
2026年7月27日、共有チャットと Artifacts が検索に出た
| 項目 | 事実 |
|---|---|
| 発覚 | 2026年7月27日にTechCrunchが報道、翌28日にITmedia。Redditユーザーが site:claude.ai/share という検索で発見した |
| 対象 | 共有チャットと Artifacts の両方 |
| 中身 | 医療・サービス関連の具体的な記述や、個人・センシティブ情報を含むものがあったとされる |
| Anthropic の説明 | 「フォーラムやSNS投稿など、検索エンジンがクロールできる場所にリンクが掲載された場合に限られる」 |
| 対応 | 7月27日午後の時点では是正されたとみられる。件数は報じられていない |
Artifacts で社内向けのダッシュボードや集計表を作った方は、少なくない数いるはずです。売上の推移、在庫の一覧、顧客ごとの対応履歴。「リンクを知っている人だけが見る」つもりで作ったものが、検索で出た。
なぜ、除外の指示が効かなかったのか
ここが、この記事でいちばん持ち帰ってほしいところです。
ある技術記事が2026年7月29日時点で確認した構成を引きます。
| パス | robots.txt | ページ側の指示 |
|---|---|---|
共有チャット /share/* | Disallow あり | HTTPヘッダに X-Robots-Tag: none(noindex と同義) |
公開Artifact /public/artifacts/* | 記載なし | HTMLの meta に noindex, nofollow |
一見すると、二重に守られているように見えます。「クロールするな」と「インデックスするな」の両方が書いてある。
ところが、この2つを併用すると機能しません。
クロールを止めると、クローラーはページの中身を取得できません。中身を取得できないということは、中に書いてある「インデックスするな」という指示にも到達できないということです。
「入るな」と書いた扉の内側に「この部屋の写真は載せないでください」と貼っても、扉の前で引き返した人は、その貼り紙を読めません。
除外の指示が二重にあったのに、二重だったせいで効かなかった。
そして発見の経路は、こうです。利用者自身が Reddit や X や GitHub に共有URLを貼った → 検索エンジンがそのリンクを辿った → 認証なしで開ける公開ページだったので、インデックスされた。
なお、ここは正直に書きます。**私はこの記事を書いている時点で、claude.ai/robots.txt を自分で開いて現在の記述を確認できていません。**だから「2026年7月29日時点で、ある技術記事がこう報告している」という書き方に留めています。この記事の最後で、その理由に戻ります。
1年前、同じことが ChatGPT でも起きている
これを「Claudeの問題」として読むと、いちばん大事なところを取り逃します。
| ChatGPT(2025年8月) | Claude(2026年7月) | |
|---|---|---|
| きっかけ | 利用者が「検索エンジンと共有する」チェックボックスを自分で入れた(明示的なオプトイン) | 利用者が共有URLをクロール可能な場所に貼った |
| 結果 | 個人的な会話が Google 検索に出た | 共有チャットと Artifacts が検索に出た |
| 提供側の対応 | **機能ごと削除。**CISO は「短命な実験」と表現し、「ユーザーが意図しない内容を誤って共有する可能性が多すぎた」と説明 | 是正されたとみられる |
ChatGPT のほうは、**利用者が自分でチェックを入れています。**同意を取っていた。それでも OpenAI は「意図しない共有が多すぎる」と判断して、機能そのものを消しました。
同意を取れば安全、ではない。 設計した側が、そう判断して降りた実例です。
1年のあいだに、別々のベンダーで、同じ形の事故が2回起きている。これはどちらかの会社が不注意だった、という話ではありません。共有リンクという仕組みそのものが持っている性質です。
持ち帰るのは、この一行
noindex は「検索よけ」であって、「アクセス制御」ではありません。
検索結果から消えても、URLを知っている人は開けます。だから、こう扱うのが正しい。
共有リンクは、鍵のかかっていない公開URLだと思って扱う。
これはAIに限りません。クラウドストレージの共有リンクも、アンケートフォームの回答一覧も、議事録ツールの共有ページも、全部同じです。「リンクを知っている人だけ」は、アクセス制御ではなく運用の願望です。
社内で決めておくべきことは、この記事の範囲では3つだけです。
- 何を共有リンクに載せてよいかを決める。顧客名、金額、個人情報が入るなら、共有リンクは使わない
- **貼った場所を記録する。**どこに貼ったか分からないリンクは、後から回収できません。「Slackのどこかに貼った」は、回収できないのと同じです
- **定期的に、発行済みのリンクを見に行く。**多くのサービスは設定画面から共有中の一覧を確認・失効できます。Claudeなら「設定 → プライバシー → 共有チャット」から確認できます
そして、これは今回の件に限った話ではありません。同じ性質を持つものが、どの会社にもあります。
- クラウドストレージの「リンクを知っている全員」設定
- アンケートフォームの回答一覧ページ
- 議事録ツールや資料共有ツールの共有ページ
- 社外向けに一度だけ出した、資料のダウンロードURL
どれも「リンクを知っている人だけ」で運用されていて、リンクがどこまで広がったかを誰も追えていないことが多い。今回のように検索に出るかどうかは、その先の話でしかありません。
このあたりはなぜ「会社のAI」でなければいけないのかと「AIのルールを作りたい」と言われて、4項目にしましたに続きます。
補足 ── 熱そのものが罠になることもある
同じ年の3月31日、Claude Code のソースコードが流出しました。原因は、Bun というランタイムが既定で生成するソースマップを、.npmignore と package.json の files フィールドで除外していなかったこと。公開された npm パッケージに 59.8MB のソースマップが同梱され、約513,000行・1,906ファイルのTypeScriptが読める状態になりました。
※ これは Anthropic自身のソースコードの話で、モデルウェイト、セーフティパイプライン、利用企業のデータは含まれていません。
ここでも、原因が地味であることが重要です。AIの能力とは何の関係もない。パッケージングの除外設定を書き忘れた、それだけです。
問題はそのあとでした。流出の翌日には、便乗キャンペーンが始まっています(トレンドマイクロ、2026年4月7日)。
- 「流出ソースコード」「アンロックされたエンタープライズ機能」を騙る偽のGitHubリポジトリ
- 画像として埋め込まれた偽のダウンロードボタン、GitHub Releases 経由のトロイの木馬化された7zアーカイブ
- 配布物は Vidar(ブラウザの認証情報、暗号資産ウォレット、セッショントークンを窃取)と GhostSocks(感染マシンをSOCKS5プロキシとして悪用)
- Claude Code 関連で104件のキーワード誘引リポジトリが確認され、うち2件が実際に悪意あるペイロードを配布していた
**「話題になっている」こと自体が、餌になりました。**煽りは、それを見た人の判断を歪めるだけでなく、その熱に寄ってくる第三者を呼びます。
なぜ、これらは流れてこないのか
ここまで挙げた事故を思い出してください。
- robots.txt と noindex の相互作用
- 共有リンクとアクセス制御の違い
.npmignoreの除外設定
どれも「やばすぎる」「神」「最強」の型に乗りません。
驚きが在庫である以上、仕入れられるのは驚けるものだけです。事故は驚きの在庫にならない。だから仕入れられず、流れてこない。
結果として、導入の速度を上げる情報だけが運ばれ、安全側の情報が運ばれません。
これが「現場の安全性が壊れる」の中身です。誰かが嘘をついたからではありません。流れてくる情報が、最初から片側だけだからです。
同じ構造の話はClaudeがAIテスト中に実在企業へ侵入でも扱いました。あの件も、能力の話としては流れましたが、運用の話としてはほとんど流れませんでした。
うちが、やりかけた失敗
ここまで書いてきて、自分に跳ね返る話をしないのは不誠実なので、書きます。
**うちも38本、AIの記事を書いています。**同じ構造の上に乗っている自覚があります。実際、危ないところまで行ったことが何度もあります。
| 何を書きかけたか | どうなったか |
|---|---|
| ある業界団体の「715件の診断結果」を、記事の根拠に使おうとした | 調べたら、AI展示会の来場者による5分程度の自己診断だった。芯には使えず、脚注に落とした |
| 「HTMLとCSSには条件分岐がない」と書いた | 事実として誤り(@media などがある)。公開前に修正 |
| LP制作についての記事を1本、最後まで書き上げた | 「自分たちにまだ言う権利がない」「エビデンスに基づいておらず内容が浅い」と判断して破棄 |
| 書店のブックカバーを「サイズ別に用意された既製品から選んでいる」と書いた | 指摘を受けて調べ直したら、一枚の紙をその場で折っていた。前回の記事を書き直した |
4つとも、悪意はありません。調べ方が足りなかっただけです。
特に1つ目が典型でした。「715件」という数字は、見た瞬間に説得力があります。そのまま使えば記事は締まる。調べに行かなければ、そのまま出ていました。
だから、こう思っています。
驚き屋は職業ではなく、状態です。 締切があって、材料が足りなくて、目の前に都合のいい数字がある。その3つが揃えば、誰でもなります。
人にラベルを貼っても、この問題は解けません。
判定は、人ではなく投稿ごとにやる
「あの人は驚き屋だ」という判定は、たいてい外れます。同じ人が、ある日は丁寧な検証記事を書き、別の日は雑なまとめを流します。
だから、投稿ごとに5つ聞くのがいい。
| # | 質問 | 通らないときに起きること |
|---|---|---|
| 1 | **その人は何を売っているか。**情報そのものが商品なら、驚きは在庫 | 熱量の理由を読み違える |
| 2 | 分母はどこか。「〇〇社が導入」の〇〇社は、全体の何%か | 上位1%の話を、自社の基準にしてしまう |
| 3 | **デモか、運用か。**一度動いた記録か、毎日動いている記録か | 動いた1回を、動き続ける前提にしてしまう |
| 4 | **「向いていない場合」が書かれているか。**1行もなければ、それは営業資料 | 判断材料が片側しか手に入らない |
| 5 | **一次資料に辿れるか。**リンクの先が別のまとめ記事なら、そこで止まる | 伝言ゲームの末端を根拠にする |
5つ全部を毎回やる必要はありません。自分の会社にお金を使わせる判断に関わるときだけでいい。
この記事を、5つに通すと
自分でやってみます。
| # | この記事は | 判定 |
|---|---|---|
| 1 | 何を売っているか | **売っています。**業務システムの開発と伴走です。だから「慌てるな」と書くことが自社の利益になる場面がある、と読んでください |
| 2 | 分母はどこか | Ramp のデータには分母を書きました。ただし調査元自身が「サンプルはやや技術寄り」と注記しています。実際の普及率は、この数字より低い可能性があります |
| 3 | デモか、運用か | 「うちはもう手遅れですか」と聞かれた回数は、私の観察です。**統計ではありません。**数えていないので件数も書いていません |
| 4 | 向いていない場合 | 最後の節に書きます |
| 5 | 一次資料に辿れるか | 出典は全部末尾に置きました。**ただし robots.txt の構成だけは、私自身が一次で確認できていません。**上でそう書いたのは、この5番目に自分で引っかかったからです |
5番は、正直に言えば書き直すべきところです。次に更新するときに、自分で確認して直します。
それでも、「SNSを見るな」とは書きません
最後に、この記事が向いていない場合を書いておきます。
**SNSでAIの情報を追うこと自体は、やめなくていいと思っています。**うちもFacebookとXで発信していますし、そもそもお客さんが来る道は、たいていここです。
SNSで煽られる → 自分で調べてみる → 分からない → 人に頼む
この流れの、最初のひと押しは煽りが担っています。それがなければ、そもそも調べ始めない。入口としては機能しているのです。
問題は、そこから先の速度です。
発信側の速度と、自分の現場の速度を、同じにしてしまうこと。
発信者は毎日新しいものを紹介できます。在庫を切らせないので。でもあなたの会社は、毎日新しい仕組みを導入することはできません。1つ入れたら、それが根づくまで数か月かかります。この違いを、AI研修が定着しない理由にも書きました。
技術の曲線は、勝手に伸びていきます。放っておいても伸びる。追いかける必要はありません。
現場は、階段でいい。
まとめ
- 対象は「YouTubeやXの、個人のペルソナを持ったAI情報発信専用アカウントが、エンドユーザー向けに出す情報」。境目は熱量ではなくその人が何を売っているか
- 技術の進歩は指数関数的でいい。**だが現場への浸透は階段でいい。**驚き屋の害は、この2本を1本に見せること
- 彼らは嘘をついていない。欠けているのは分母だけ。最上位モデルは企業が買ったトークンの6%、AI支出の中央値は従業員1人あたり月$11.95で、上位1%との差は約620倍
- Googleですら、Geminiのデモ動画を編集していた。捏造ではなく編集。動画は「こう見せたい」順に並べ替えられる
- 害は2方向。止まる(未取組73.6%、理由1位は「活用する業務がイメージできていない」63.4%)か、壊す(検証なき実装が、台帳の横に置き場を作る。二重入力の経験者は56%)
- 2026年7月、Claudeの共有チャットとArtifactsが検索に出た。Disallow と noindex を併用すると、クロールが止まって noindex が読まれない
- 1年前、ChatGPTでも同じ形の事故。しかもあちらは利用者が自分でチェックを入れていた。OpenAIは機能ごと削除した。同意を取れば安全、ではない
- **noindex は「検索よけ」であって「アクセス制御」ではない。**共有リンクは、鍵のかかっていない公開URLとして扱う
- こうした事故は**「驚き」の在庫にならないので流れてこない**。導入を速める情報だけが運ばれ、安全側が運ばれない
- 驚き屋は職業ではなく状態。締切と、材料不足と、都合のいい数字。3つ揃えば誰でもなる
- 判定は人ではなく投稿ごとに5つ。売っているもの/分母/デモか運用か/向いていない場合/一次資料
「うちはもう手遅れですか」と思っているなら、まだ何も遅れていません。中央値の会社は、従業員1人あたり月12ドルしか使っていないので。 何から始めるかだけ決めたい、という段階のご相談も承ります。業務診断からどうぞ。診断だけで終わっても構いません。
出典・参考
- 【現代AI童話「驚き青年」】──「生成AIはヤバい!」と叫ぶ人たちの末路(ITmedia AI+、2024年9月12日、マスクド・アナライズ)
- 「プロ驚き屋」・「驚き屋」の意味と英訳(takashionary)
- Google's best Gemini demo was faked(TechCrunch、2023年12月7日)
- August 2026 Ramp AI Index: Cracks in the AI thesis(Ramp)
- 2026年版 中小企業白書・小規模企業白書の概要(中小企業庁)
- 「DXが進んでもなくならない『二重入力』働く人の56%が経験」(株式会社オロ、2026年5月)
- Claude、一部チャットがGoogle検索で"丸見え"に(ITmedia、2026年7月28日)
- Claudeの共有チャットやArtifactsがGoogle検索に露出した件(クラスメソッド、2026年7月27日)
- Claude共有リンク・公開Artifactが検索に出る問題(robots.txt と noindex の構成、2026年7月29日確認)
- OpenAI kills "short-lived experiment" where ChatGPT chats could be found on Google(Malwarebytes、2025年8月1日)
- Claude Code Leak: Critical AI Security Threat 2026(Zscaler)
- 信頼シグナルの悪用:Claude Codeの誘引とGitHubリリースのペイロード(トレンドマイクロ、2026年4月7日)
- 情報商材(各種相談の件数や傾向)(国民生活センター)
Read next
他の記事
「間違えないAI」は、何を間違えないのか──Jevの正しい疑い方と、御社で入る場所
文章を書かないAI「Jev」は「ハルシネーションしない」と宣伝されています。本当です。ただしそれは「用意した選択肢の外は出ない」という意味で、「選び方が正しい」という意味ではありません。第三者の試験では、単純なキーワードのルールに負け(97.2%対91.7%)、自信の数字が当てにならない例も出ています。日本語はまだ検証されていません。だから使い方は「人の代わり」ではなく「人の前の下読み」。問い合わせの振り分け・請求書の仕分け・口コミの採点には入り、返信文・報告書・写真には入らない。御社の業務のどこに入るかを、専門用語なしで書きます。連載第2回。
読む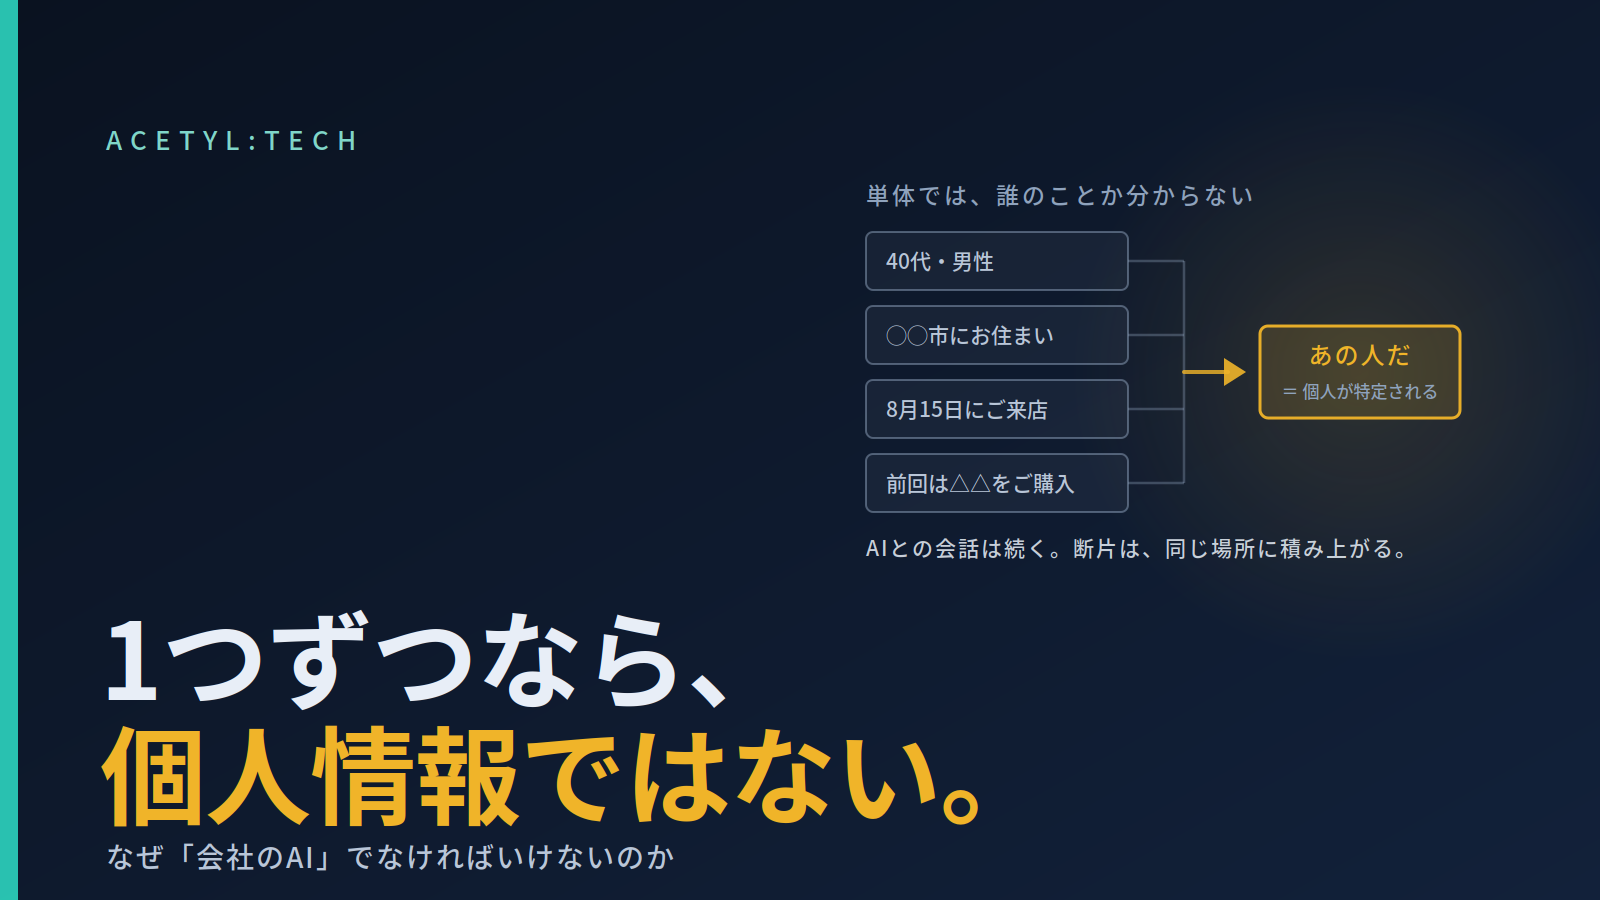
なぜ「会社のAI」でなければいけないのか──仕組みから見た、マスキングが要る5つの理由
AI利用ルールに「顧客情報は会社のAIにだけ」と書きましたが、理由を説明していませんでした。理由を知らないまま守られるルールは、忙しい日に破られます。「学習に使われないから安全」は半分しか正しくない——学習と保存は別の論点です。そして2002年、氏名を削除した医療データから州知事の記録が特定された事例。使われたのは生年月日・性別・郵便番号の3つだけでした。仕組みから見た5つの理由と、何を消して何を残すかまで。
読む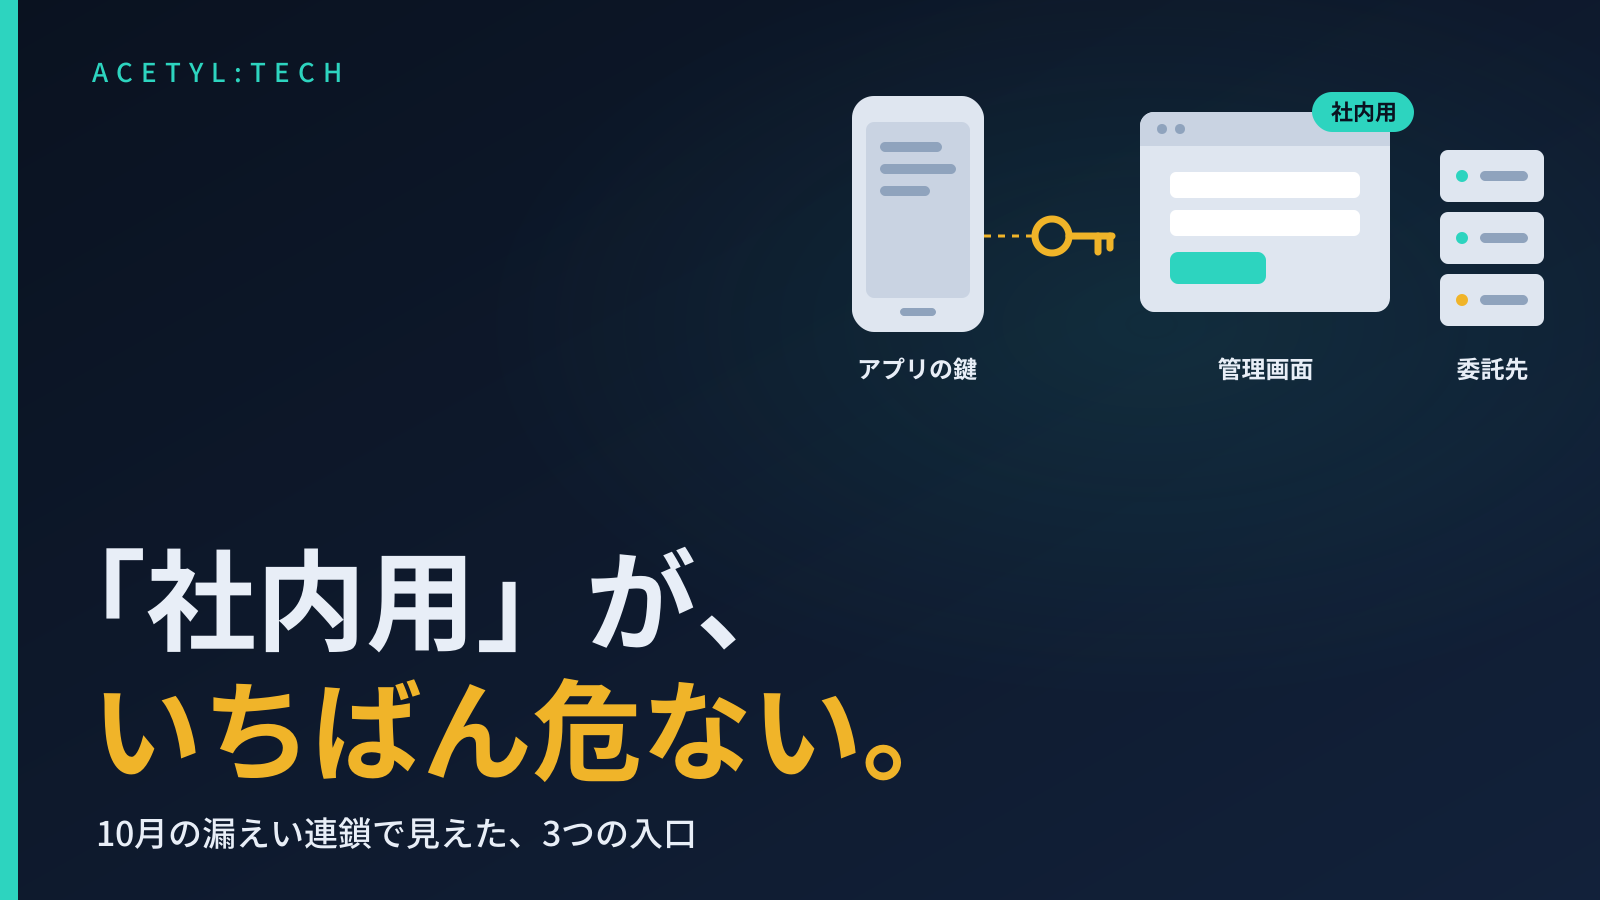
「社内用だから大丈夫」が、いちばん危ない──10月の漏えい連鎖で見えた、3つの入口
2026年9月の終わりから、大きな会社の個人情報漏えいの発表が相次ぎ、10月7日から9日の3日間で、国の機関などから注意喚起が8本出ました。ただ、各社の発表を読むと、どうやって入られたのかはほとんど書かれていません。手口が分かるのは、JPCERT/CCとマクニカが実際の対応から書いた資料だけです。それと各社の発表に残った数少ない言葉を突き合わせると、入口は3つに絞れます。アプリの中の鍵と画面の裏のAPI、「社内用」の管理画面やBIツール、そして委託先。どれも「表には出していないつもり」の場所で、中小企業にもそのままあります。業者や担当者に聞ける質問の形にしました。うちも委託先なので、自分たちの側の話も書きます。
読む